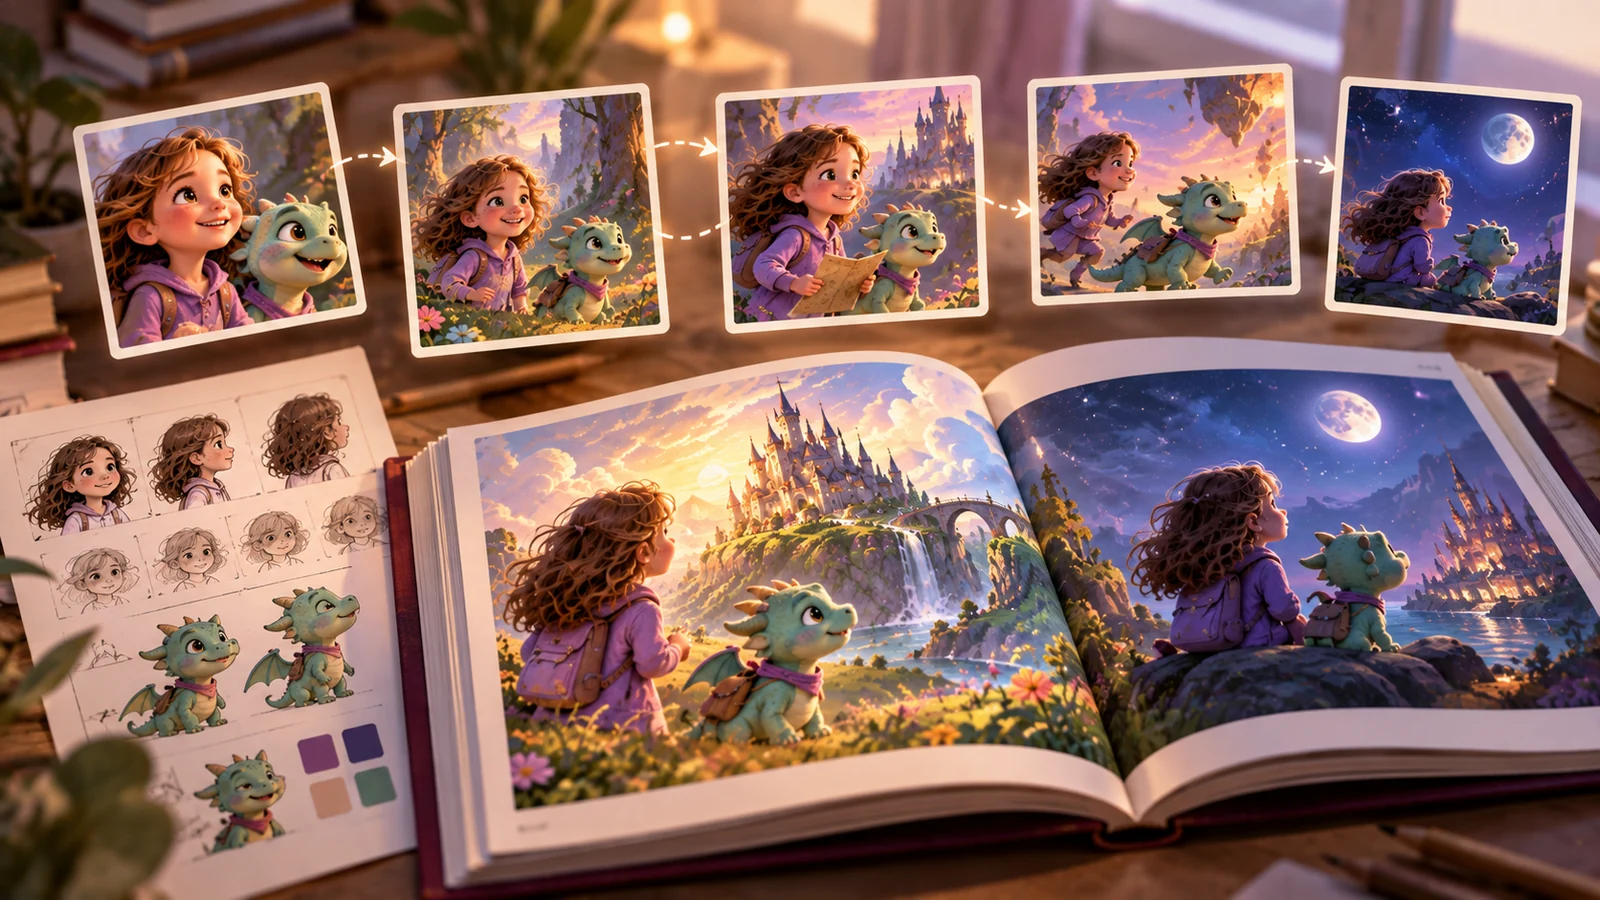
На уровне одной картинки почти всё может выглядеть отлично. На уровне последовательности начинают проявляться проблемы, которые одним «хорошим промптом» уже не решить. Мы столкнулись с этим, когда начали собирать длинные персонализированные иллюстрированные истории, и довольно быстро выяснилось: качество отдельной генерации и качество генеративного продукта — совсем не одно и то же.
Одна красивая сцена ничего не гарантирует
Допустим, мы создаём историю про ребёнка и маленького дракона. Первая иллюстрация получилась отлично. На второй герой всё ещё похож на себя. На пятой немного изменилась причёска. На восьмой куртка стала другого цвета. На двенадцатой лицо уже заметно отличается от первого изображения. А дракон тем временем успел поменять форму рогов, оттенок кожи и пропорции крыльев.
Каждая из картинок по отдельности может быть вполне качественной. Но если поставить их рядом, возникает ощущение, что иллюстрации относятся к разным книгам. Для генеративной модели в этом нет ничего удивительного — она каждый раз решает новую задачу. Для пользователя это просто ошибка. И здесь появляется первая важная граница: визуальное качество отдельного output и визуальная непрерывность серии — разные характеристики продукта.
Самое очевидное решение может усилить проблему
Кажется логичным использовать предыдущую картинку как reference для следующей — получается цепочка сцена 1 → сцена 2 → сцена 3 → сцена 4. Поначалу это действительно помогает. Но возникает другая проблема — накопление изменений. Допустим, во второй сцене генератор немного изменил форму лица. Третья сцена уже получает изменённое лицо как исходную точку, и в ней немного меняется причёска. Четвёртая наследует уже оба изменения. Небольшие отклонения постепенно становятся новым стандартом — это немного похоже на многократное копирование копии: каждая отдельная итерация выглядит приемлемо, но на длинной дистанции исходник начинает теряться.
Поэтому мы в итоге пришли к другой модели: не предыдущая сцена является источником истины для героя, а отдельный канонический reference. У персонажа есть утверждённый визуальный образ, и каждая новая сцена снова отталкивается от него. Сцены перестают наследовать ошибки друг друга.
Reference должен принадлежать персонажу, а не картинке
Эта идея хорошо работает с главным героем. Но затем появляется второстепенный персонаж. Например, у ребёнка есть спутник — маленький плюшевый трицератопс, который появляется на 12 из 23 разворотов. Можно каждый раз писать в промпте «маленький плюшевый трицератопс», но модель совершенно не обязана понимать это как «тот самый маленький плюшевый трицератопс, которого мы показывали семь сцен назад» — для неё каждый запрос снова допускает интерпретацию.
Поэтому важные повторяющиеся персонажи тоже начинают требовать собственной визуальной идентичности. Не все: если в одной сцене мимо героя пролетела случайная бабочка, создавать для неё отдельный reference бессмысленно. Но если персонаж влияет на сюжет и возвращается снова, ему полезно дать несколько устойчивых признаков — например: плюшевый трицератопс, мятно-зелёная ткань, два коротких светлых рога, фиолетовый шарф.
После этого для персонажа создаётся отдельный эталон, и в сцену передаются только те references, которые действительно нужны: главный герой плюс персонажи конкретной сцены. В какой-то момент мы сформулировали для себя довольно простой принцип: reference должен принадлежать сущности, а не предыдущему результату генерации. Он оказался полезен далеко за пределами конкретной реализации. Мы подробнее разбирали эту механику в материале о том, как мы сохраняем любимых персонажей ребёнка узнаваемыми на протяжении всей книги.
Но нельзя просто описать всё максимально подробно?
Это следующий естественный шаг. Если персонаж меняется, хочется добавить в каждый запрос больше деталей: не «маленький дракон», а «маленький фиолетовый дракон с кремовым животом, двумя золотистыми рогами, тремя шипами, большими зелёными глазами, короткими лапами, оранжевыми внутренними частями крыльев» — и ещё десять признаков.
Проблема в том, что промпт постепенно превращается в техническую спецификацию персонажа, и эта спецификация начинает конкурировать с самой сценой. Модели одновременно нужно понять, кто находится в кадре, как персонаж выглядит, что происходит, где это происходит, какое освещение, какая композиция, какой художественный стиль и какие объекты важны. Поэтому в production у нас лучше работает другой подход: описать несколько действительно различающих признаков, а остальное закрепить визуальным reference. Не нужно каждый раз заново объяснять всё, что модель уже может увидеть.
Главный герой — только половина проблемы
Даже если все персонажи стали стабильными, длинная визуальная история всё ещё может разваливаться. Представим последовательность: в первой сцене ребёнок находит золотой ключ, в следующей несёт его с собой, потом ключ исчезает, а через пять разворотов появляется снова, но уже серебряный. Или: герои входят в замок вечером, следующая сцена внезапно происходит солнечным днём, затем снова ночь. Или мост, который в одной сцене ведёт к башне, дальше оказывается совсем в другом месте.
Здесь уже мало контроля внешности персонажей — нужно сохранять состояние мира. То есть длинный генеративный контент начинает неожиданно напоминать обычное приложение: у него появляются данные о том, какие персонажи существуют, какие объекты уже найдены, где находится герой, что произошло раньше, какие отношения установлены, что является постоянным свойством мира, а что было временным состоянием конкретной сцены. Если всё это оставлять исключительно внутри prompt history, результат становится слишком зависимым от способности модели каждый раз правильно реконструировать прошлое.
Чем длиннее генерация, тем важнее память самого продукта
Это, пожалуй, один из главных выводов. При создании короткого AI-контента можно полагаться почти исключительно на модель: нужен пост — передали контекст и получили пост, нужна картинка — передали описание и получили изображение. Но длинный генеративный продукт требует собственной памяти — не в смысле «нейросеть должна помнить предыдущий чат», а в смысле: приложение само хранит canonical state.
Это состояние обычно складывается из нескольких слоёв: как выглядит главный персонаж (hero), какие повторяющиеся герои существуют и как они выглядят (secondary cast), что уже произошло и какие элементы должны сохраниться (story state), какие правила мира нельзя случайно изменить (story bible), и к какой конкретной версии истории относятся текст и изображения (revision). В какой-то момент модель становится уже не местом хранения истины, а исполнителем — система сообщает ей, что является истиной в данный момент. Это гораздо предсказуемее.
23 хорошие картинки ещё не дают хорошую книгу
Есть ещё одна ловушка: оценивать качество по отдельным генерациям. Можно открыть каждую сцену и поставить ей условные 9 из 10 — красиво, композиция хорошая, герой приятный, свет отличный. Но собрать все изображения подряд — и получить плохой продукт.
Поэтому для последовательного AI-контента появляется дополнительная метрика качества — continuity: насколько результат N совместим с результатом N−1 и со всей историей до него. Это уже не вопрос «насколько хороша эта картинка?», а вопрос «верит ли пользователь, что это следующий момент той же истории?». Для длинного контента второй вопрос иногда важнее первого. Чуть менее эффектная сцена с правильными героями и состоянием мира может работать лучше, чем великолепная картинка, которая ломает непрерывность.
Визуальная непрерывность — не единственная
Точно такая же проблема возникает с текстом. Если генерировать каждую сцену независимо, модель может повторно представить уже знакомого персонажа, второй раз объяснить правило мира, забыть найденный предмет, изменить мотивацию героя, повторить одно и то же сюжетное действие или решить проблему, которая уже была решена.
Поэтому задача постепенно перестаёт звучать как «напиши 23 хороших фрагмента» и начинает звучать как «создай одну историю, которая технически представлена 23 фрагментами». Разница кажется небольшой. Для архитектуры системы она огромна.
Больше правил тоже может ухудшить результат
Когда видишь такие ошибки, естественная реакция — добавлять инструкции: герой должен быть постоянным, спутник должен быть постоянным, предметы не должны исчезать, стиль нельзя менять, возраст нужно учитывать, сюжет должен быть цельным. После нескольких итераций system prompt превращается в небольшой нормативный документ — и здесь возникает противоположная проблема. Модель начинает слишком хорошо выполнять внутренние правила и хуже писать сам контент.
Например, если подробно описать safety-ограничения, в тексте внезапно появляются фразы вроде «дверь была совершенно безопасной» или «герой ничуть не испугался и ему ничего не угрожало». Система выполнила инструкцию буквально, но пользователю совершенно не обязательно знать о внутренней инструкции. Поэтому мы постепенно начали разделять две вещи: правила определяют пространство допустимых результатов, но не обязательно должны проявляться в самом результате. Это тоже довольно универсальный принцип генеративного UX.
Production начинается там, где появляется fallback
Есть ещё один хороший индикатор перехода от эксперимента к продукту: что произойдёт, если один из этапов не сработал? Например, не удалось создать reference второстепенного персонажа. В прототипе ответ часто простой — генерация упала. В продукте приходится выбирать: остановить создание всей истории, повторить запрос, продолжить без reference, отметить сцену для проверки или использовать только текстовое описание.
Здесь уже нет универсального AI-ответа — это обычное продуктовое решение с компромиссами между стоимостью, временем, качеством, вероятностью ошибки и пользовательским ожиданием. Самая интересная часть AI-продуктов довольно быстро начинает происходить не внутри модели.
Один промпт постепенно превращается в систему
На раннем этапе архитектура выглядит примерно так: user input → prompt → model → result. Это отличный способ быстро проверить гипотезу. Но длинный генеративный контент довольно естественно превращает её во что-то вроде: user input → structured state → generation contract → model → validation → canonical assets → next generation. А рядом с этой цепочкой существуют references, версии, retry, fallbacks, moderation, права доступа и пользовательские правки.
Сам prompt никуда не исчезает. Он просто перестаёт быть главным местом, где живёт вся логика продукта.
Почему это, вероятно, касается не только историй
Мы столкнулись с этой проблемой на длинном иллюстрированном контенте, но паттерн кажется гораздо шире. В AI-игре персонаж должен помнить предыдущие решения пользователя. В AI-курсе следующее занятие должно учитывать реальные ошибки из предыдущего. У виртуального собеседника характер не должен полностью меняться между сессиями. В генераторе презентаций тридцатый слайд должен визуально принадлежать тому же документу, что и первый.
Во всех этих случаях качество постепенно начинает зависеть не только от способности модели создать хороший следующий output. Нужно ещё сохранить идентичность системы между output’ами.
Одна картинка всё ещё легко. Двадцатая — уже продукт
Современные модели очень хорошо показывают магию AI на первом экране: загрузил данные, нажал кнопку, через несколько секунд появился впечатляющий результат. Но настоящий тест начинается позже — когда пользователь открывает пятую страницу, возвращается через неделю, создаёт продолжение, встречает старого персонажа, меняет один параметр, но ожидает сохранить остальные.
Именно здесь генеративная система перестаёт быть демонстрацией возможностей модели. Она должна начать вести себя как продукт. Наверное, самый полезный вывод из нашего опыта пока звучит так: чем длиннее AI-контент, тем меньше его качество определяется одним промптом и тем больше — тем, что продукт умеет сохранить между генерациями. И одна хорошая картинка здесь действительно оказывается самой простой частью задачи.